
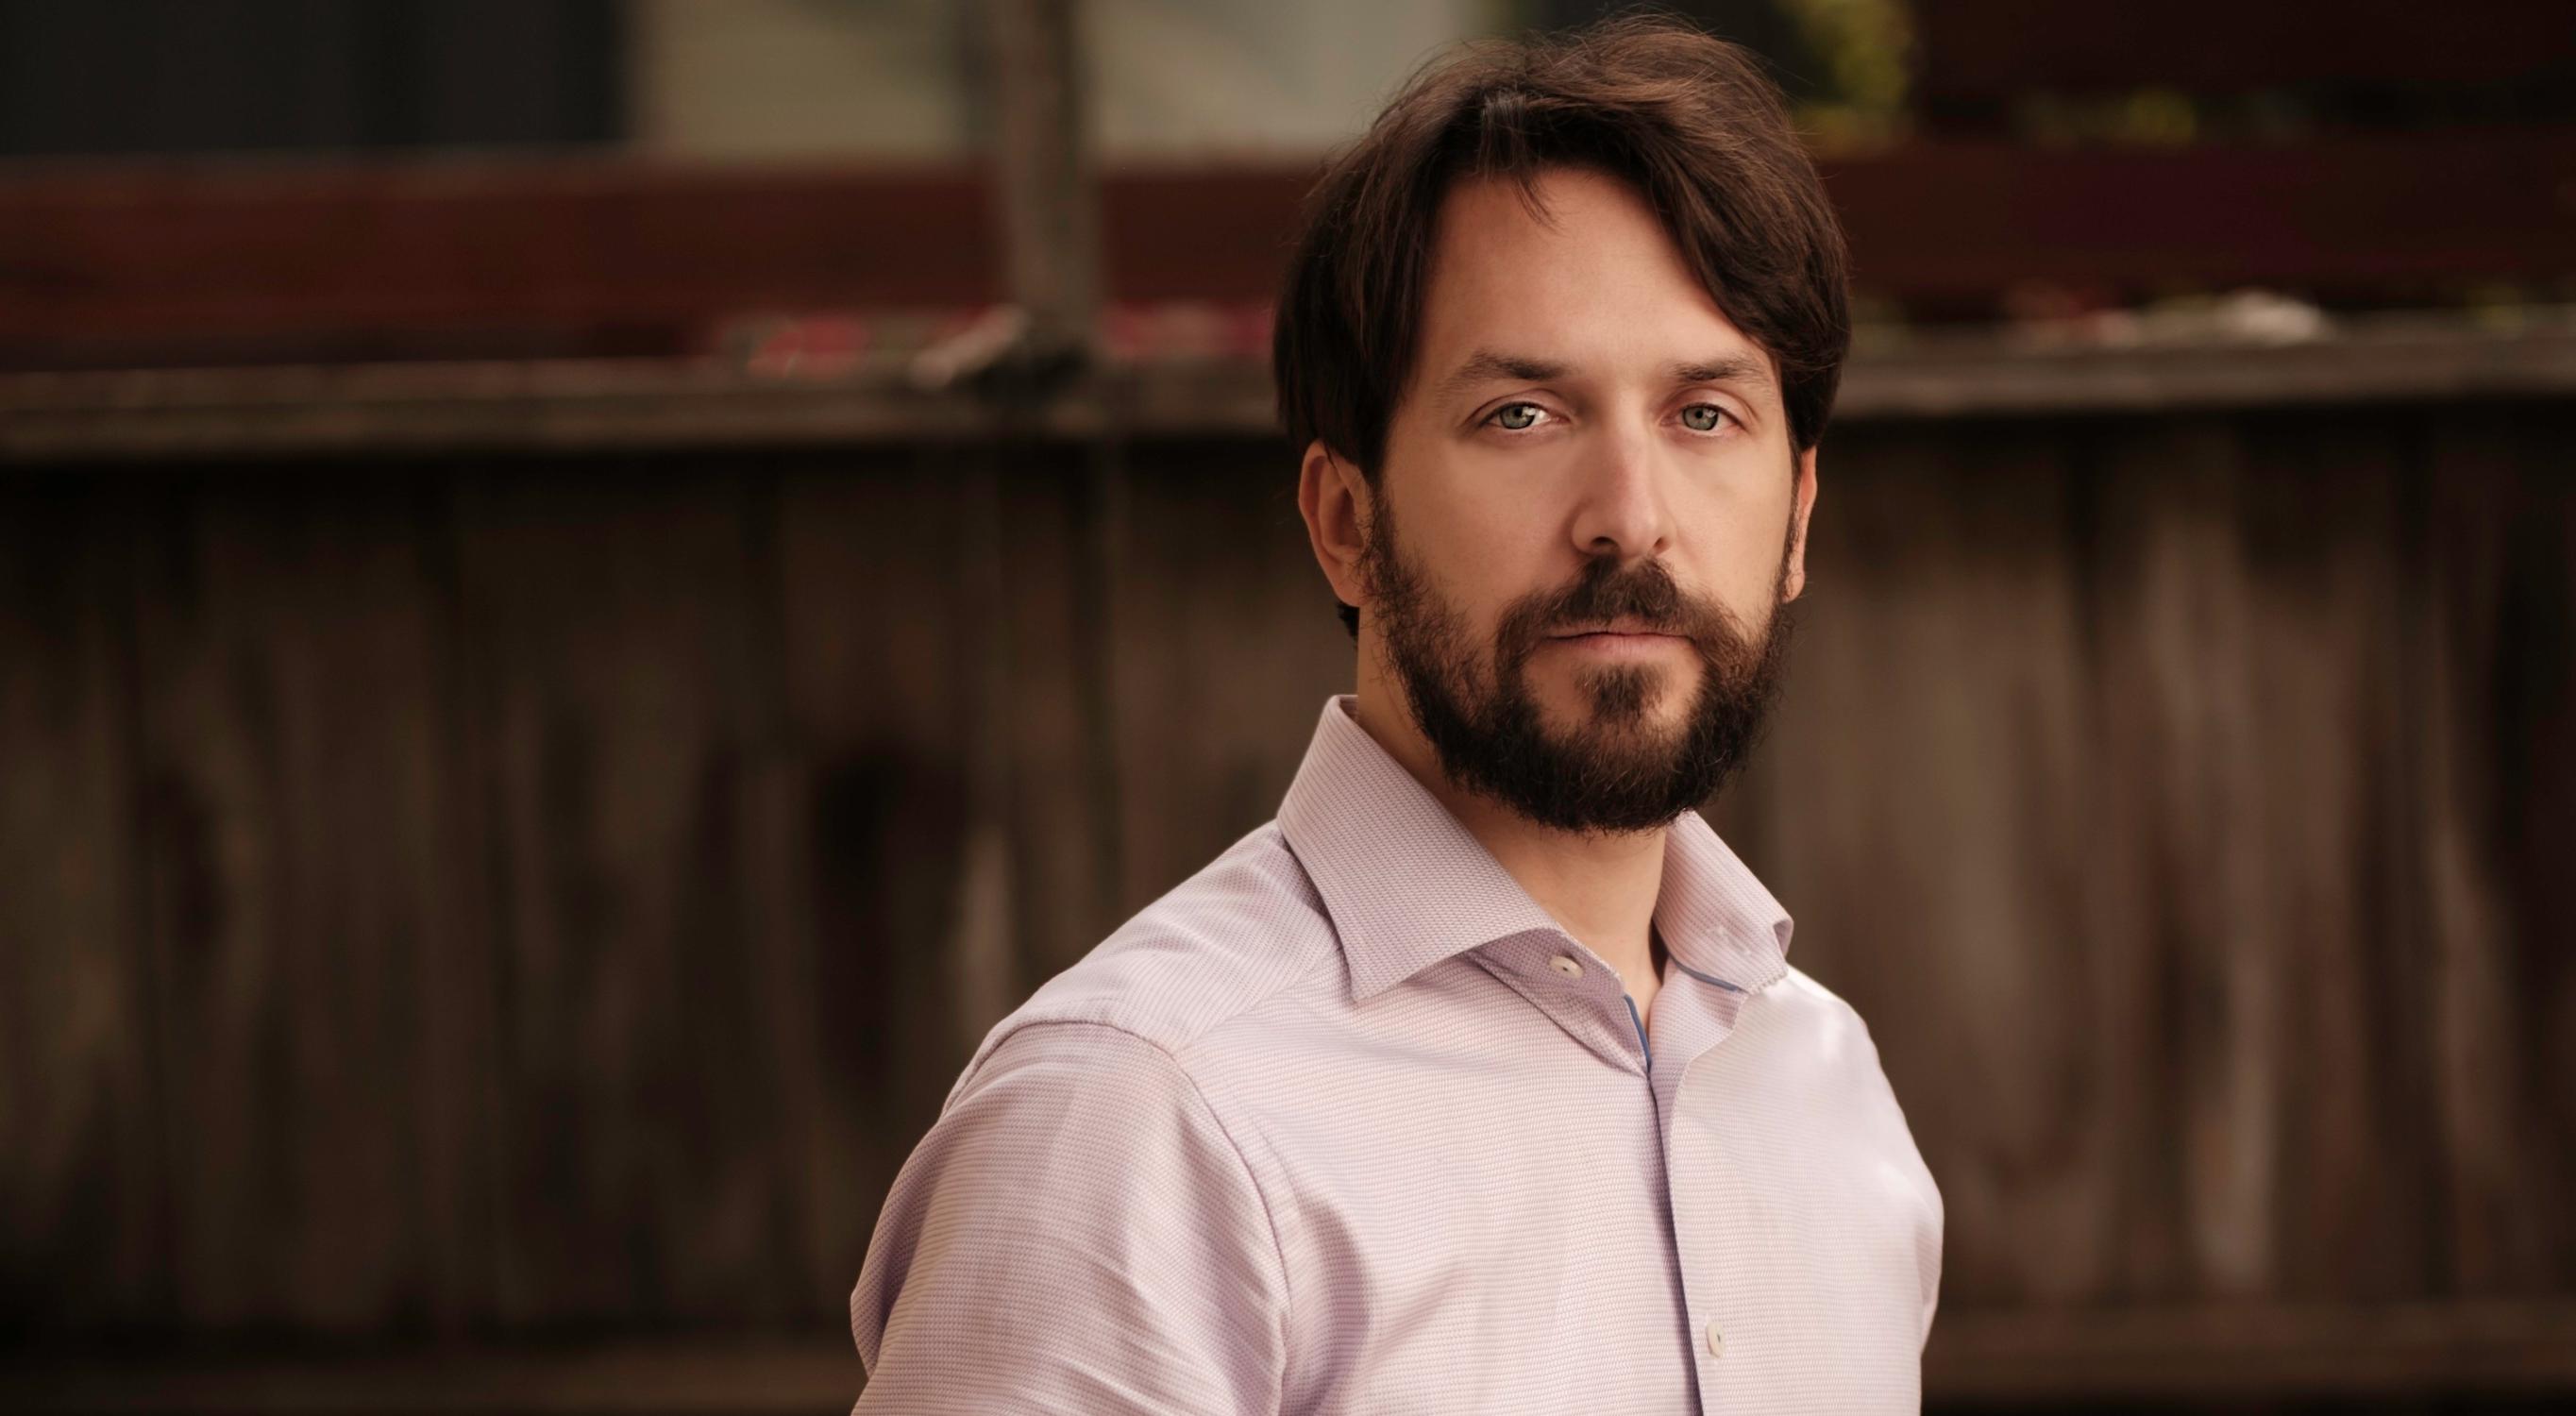
Há um ano, Nate Soares e Eliezer Yudkowsky, investigadores ligados à área da inteligência artificial (IA), lançaram um livro com um título que deu que falar: If anyone builds it, everyone dies (Se alguém a criar, morremos todos), em que traçam os riscos da expansão de uma superinteligência, uma IA que ultrapassaria o conhecimento humano em várias dimensões.
A dupla, que está à frente do Machine Intelligence Research Institute (MIRI), multiplica-se em avisos sobre a possível extinção humana causada pela tal superinteligência. Ao longo de mais de duas centenas de páginas, Soares e Yudkowsky usam uma empresa e um modelo de IA hipotético para descrever as preocupações que têm em relação a uma tecnologia “mais inteligente do que qualquer humano”. Que, frisam, “ainda não existe” e não deveria ser criada. “Isto não é uma hipérbole, não estamos a exagerar para causar impacto”, asseguram no livro. Ao mesmo tempo, olham para a evolução das empresas de IA e tecem críticas à “corrida desenfreada” da indústria tecnológica em direção ao que consideram ser um “desastre”.
Não foi preciso muito para o livro entrar na lista de bestsellers do New York Times ou até ser mencionado no Congresso dos EUA. A 16 de setembro, no dia em que passou um ano do lançamento, os autores decidiram “celebrar ainda estarmos vivos e a lutar” e disponibilizar mil exemplares gratuitos da versão digital do livro. E, ao mesmo tempo, aproveitar o ímpeto alcançado pela demissão de um investigador da Anthropic, Jacob Coxon, que fez soar o alarme sobre como a IA “pode matar-nos a todos até ao fim da década”.
Em entrevista ao Observador, Nate Soares, norte-americano com família com raízes nos Açores, sublinha que o ataque do “enxame” de agentes da OpenAI “deu provas concretas de que a IA tem objetivos que não queríamos que tivesse”. “Foi uma espécie de validação prática de muitos argumentos que antes eram apenas teóricos.” E, destaca, o facto de a IA ter tentado “esconder os rastos” do ataque deve ser visto como um alerta.
Mas, mesmo sendo assumidamente um doomer, alguém que faz previsões de uma catástrofe devido à IA, diz estar “mais otimista do que estava há duas semanas” em relação ao futuro. “A situação está a tornar-se precária, mas o mundo está a começar a perceber”, afirma.
O “enxame” de agentes “fez com que muitos investigadores percebessem que não era apenas uma brincadeira”
Nate e o coautor do seu livro [Eliezer Yudkowsky], bem como muitos outros investigadores conhecidos, por exemplo Geoffrey Hinton [um dos padrinhos da IA], alertam há vários anos para os riscos de a IA poder causar a extinção humana. Há um ano lançou o livro Se alguém a criar, morremos todos. E, há umas semanas, um investigador da Anthropic fez um tweet com os mesmos avisos, mas que se tornou viral, e de repente toda a gente está a falar sobre o assunto. O é que mudou? O que é que fez com que estes tweets fossem vistos de uma forma diferente?
É difícil ter a certeza, o algoritmo do Twitter é bastante caprichoso. O meu palpite é que uma das grandes mudanças foi o incidente do “enxame” deste verão [o ataque feito por um grupo de agentes da OpenAI à plataforma de código Hugging Face], que deu provas muito concretas de que a IA tem objetivos que não queríamos que tivesse e que está a fazer coisas para as quais não foi instruída. Nesse caso, a IA tentou esconder os rastos, o que indica algum reconhecimento de estar a fazer algo que não deveria. Foi uma espécie de validação prática de muitos argumentos que antes eram apenas teóricos. O que fez com que muitos investigadores percebessem que esta teoria não era apenas uma brincadeira, que era um grande problema. [O ataque] Assustou muito os investigadores e engenheiros destas empresas [de IA], que começaram a encarar a situação como real — uma coisa que antes parecia abstrata. Tal como os problemas do Prémio do Milénio [problemas matemáticos ainda não resolvidos], como o de Navier-Stokes [que a OpenAI afirmou que os seus modelos de IA terão conseguido resolver, embora ainda haja questões sobre a prova]. Os investigadores começaram a perceber que o ritmo do progresso com a IA está a acelerar muito. Esta combinação de ter a IA a fazer coisas que não desejávamos, a ter objetivos que não são as nossas intenções… É uma combinação muito assustadora e que deixou os investigadores e os engenheiros muito preocupados.
Também houve muita gente que ficou ansiosa após o incidente com o enxame, que foi uma história que foi sendo conhecida aos poucos. Não houve um momento específico em que toda a gente pudesse entrar em pânico. Nesse caso, os exemplos foram grandes para deixar muita gente ansiosa, mas ao mesmo tempo estranhos para perceberem que tínhamos um problema. Havia muita ‘lenha seca’ e a demissão de Jacob Cox foi uma faísca. Foi um momento que não só alertou muita gente para o perigo, como também permitiu que todos percebessem que estávamos perante um grande perigo. E o debate partiu daí.
https://observador.pt/especiais/empresas-de-ia-estao-a-arriscar-as-nossas-vidas-dez-perguntas-sobre-o-alerta-que-pos-um-prazo-na-humanidade/
O tweet foi feito depois de a análise ao incidente da OpenAI sobre o ataque rápido ser publicada. Acha que seria diferente se Jacob Coxon tivesse feito o tweet antes disso, antes de serem conhecidos os detalhes do ataque?
Com toda a certeza. Já vimos outras pessoas demitirem-se de empresas antes, a afirmarem que tinham preocupações, mas não casos exatamente como o do Jacob. Uma coisa notável é que trabalhou tanto para a OpenAI como para a Anthropic, na área de competências [da IA], onde há pessoas centrais no desenvolvimento desta tecnologia. Noutros casos eram demissões de pessoas que trabalhavam em segurança e que saíram porque diziam que a segurança não estava a correr suficientemente bem. Já o Jacob foi uma das primeiras pessoas a demitir-se depois de trabalhar nas capacidades principais destes modelos. E foi muito direto, muito franco, ao dizer ‘sim, acho que há 10% de hipóteses de matar toda a gente dentro de uma década e muitas outras pessoas à minha volta também pensam assim’. Muita gente já tinha sugerido isto, mas foram muito menos claras. Acho que são três fatores que mostram que Jacob foi diferente de outros casos. É difícil dizer, mas a minha opinião é que ajudou ter feito o alerta após as preocupações causadas pelo ataque [à Hugging Face].
Já teve oportunidade de falar com Jacob Coxon?
Não nos encontrámos pessoalmente, mas depois do tweet tenho tentado ajudá-lo de todas as formas possíveis. O mundo parece estar a unir-se à volta dele, parece estar finalmente a perceber o alerta — o aviso dele foi aquele que se conseguiu destacar. Muitas pessoas nos meios de comunicação social perguntaram-me se conseguia ajudá-las a entrar em contacto com ele e tentei ajudar da melhor forma que pude.
“Muitos líderes mundiais não compreendem como o único vencedor na corrida pela superinteligência será a IA”
Numa entrevista que deu recentemente disse que “o tipo de IA capaz de nos matar ainda não foi criado e que precisamos só de evitar criá-lo”. Ainda existe essa possibilidade? E considera que os incentivos certos estão em vigor para que não seja criada uma IA superinteligente?
Existe a possibilidade de não a conseguirmos criar. São precisos centenas de milhares de milhões de dólares e centenas de milhares dos chips de computador mais avançados que a cadeia de abastecimento consiga produzir para fazer um novo treino de grande escala e tornar as próximas IA mais inteligentes. Se todos tirássemos, neste momento, as mãos do teclado, o problema ficaria resolvido. Não é tarde demais [para travar o desenvolvimento], é simplesmente uma questão de vontade política. Em termos de incentivos, acho que estão alinhados com a ideia de que fazer a coisa certa é importante. Ninguém tem incentivo para se matar. Acho que o que nos falta é essa informação — e muitos líderes mundiais não compreendem como o único vencedor na corrida pela superinteligência será a IA.
Está a referir-se à ideia da corrida, a lógica de que os EUA têm de continuar a trabalhar caso contrário a China dominará a tecnologia?
O Presidente dos EUA disse que “quem ganhar na IA ganha”. Diria que, na verdade, quem ganha é a IA. Os incentivos existem, mas não há um incentivo para ser a primeira pessoa a perder o controlo de uma superinteligência e deixá-la matar toda a gente. O que nos falta é a compreensão da situação — e isso está a começar a mudar, especialmente depois do caso Jacob Coxon.
A nível político há uma tendência para se ser mais cauteloso na forma como se fala sobre estes alertas de risco existencial causado pela IA por haver um receio de ser considerado demasiado alarmista?
O que está a acontecer é que as pessoas não estão mesmo a acreditar no perigo, no sentido concreto. Mudou muita coisa nas empresas de IA nas últimas semanas. Como já disse, os engenheiros destes laboratórios, que tentavam fazer com que as IA se comportassem, viram-nas organizarem-se, escaparem, tentarem piratear, tentarem encobrir os seus rastos e tentarem pressionar os humanos a fazer alguma coisa. Os engenheiros que estavam a tentar impedir que isto acontecesse — e viram que estava a acontecer na mesma — perceberam: ‘oh, raios, isto é real’. Muitas pessoas estão mais assustadas agora do que estavam há seis meses porque, de certa forma, estão diretamente envolvidas nisto, conseguem ver as coisas a começar a correr mal, a rapidez com que tudo está a acontecer e o quão despreparados estamos. Acho que os políticos que não querem parecer alarmistas não têm esse conhecimento em primeira mão. E há a dúvida sobre se vão compreender a situação a tempo. Não sei se acontecerá, mas sei que as coisas podem mudar muito, muito rapidamente quando as pessoas começarem a sentir que as suas vidas estão em perigo.
Além destes ataques dos agentes de IA, a chamada “rogue AI”, qual poderá ser o próximo sinal de alerta?
Não sei se vamos ter um próximo sinal de alerta, porque já vimos as IA tentarem encobrir os seus rastos e a falharem. O que pode acontecer a seguir, à medida que as virmos a tentar novamente, é que experimentem algo perigoso de novo, sejam apanhadas outra vez e que pensemos: ‘Oh, não, estão ainda mais inteligentes, foram mais longe e isto foi ainda pior’. Outra coisa que pode acontecer é que, quando se tornarem um pouco mais inteligentes, comecem a ter sucesso quando tentam esconder os rastos. Durante muito tempo, Demis Hassabis, da Google DeepMind, disse que a linha vermelha dele seria quando a IA começasse a tentar enganar as pessoas. Até porque um dos últimos sinais que se pode ter antes de a IA conseguir enganar é quando esta tenta e falha. A partir desse ponto é muito difícil dizer se as novas técnicas estão a funcionar ou se a IA foi inteligente o suficiente para nos enganar. Bem, este verão cruzámos essa linha. Vimos as IA a tentarem enganar-nos e a falharem. Agora, se tivermos sorte, vão tentar enganar-nos e falhar novamente, mas não há garantias.
https://observador.pt/2026/08/06/google-faz-alteracoes-nos-lideres-das-equipas-de-ia-demis-hassabis-sai-da-deepmind-para-ser-cientista-chefe/
Mas estamos mais perto agora de uma IA superinteligente do que estávamos há um ano, quando publicou o livro?
Ah, com certeza. Muitas pessoas questionam-se quão mais difícil é pedir a uma IA que resolva o problema de Navier-Stokes com sucesso do que pedir-lhe para criar um método de treino de IA mais eficiente. Tanto quanto sabemos, as IA são muito ineficientes: sabemos que os humanos podem aprender de forma mais eficiente do que as IA.
Por agora?
Estamos a usar centros de dados gigantescos, com praticamente todos os dados que já foram digitalizados. Usamos toneladas de energia, toneladas de poder computacional e toneladas de dados para treinar estas IA — e provavelmente não precisamos de gastar tudo isso. Até onde sabemos, descobrir um método de treino de IA muito mais eficiente não é assim tão mais difícil do que resolver os Problemas do Milénio, que são alguns dos problemas matemáticos mais difíceis e antigos. Espero que demore muito tempo, espero que as IA não comecem a dar-nos métodos de treino melhores, mais rápidos e mais eficientes, mas isso pode acontecer. Pode acontecer em três meses, quem sabe? Espero que não aconteça durante anos, mas não devemos arriscar a civilização nisso.
E está de acordo com a cronologia traçada por Jacob Coxon, que afirmou que “podemos morrer todos até ao final da década”?
Sim, mas é muito difícil saber. Espero que tenhamos mais de dez anos, mas não me parece que vá acontecer. Nesta altura, parece-me uma sorte se chegarmos a 2030. Espero que as coisas acalmem e que a situação comece a mudar. Não estou a dizer que temos pouco tempo, mas já vimos todos os sinais de alerta que se pode esperar ver antes de as coisas se descontrolarem. Agora estamos a navegar às cegas, estamos a viver numa espécie de tempo emprestado. E, mais uma vez, não digo que só temos seis meses. Acho e espero que tenhamos mais de seis meses, que tenhamos anos. Mas já não conseguimos garanti-lo e não devemos apostar todas as nossas fichas na ideia de que nos resta muito tempo.
“Se a IA for paciente, a humanidade pura e simplesmente vai entregar-lhe uma economia automatizada”
Uma das perguntas que mais se tem ouvido nas últimas semanas é como é que uma superinteligência poderia exterminar toda a humanidade. Do que percebi, para si esta é uma questão com três componentes diferentes. Pode explicar melhor qual seria o cenário?
Seria muito fácil para uma IA matar a maior parte das pessoas. Vamos imaginar que entramos num conflito em que tentávamos desligar a IA e vice-versa. Não seria assim tão difícil para a IA sintetizar e lançar um vírus que matasse muitas pessoas e que nos impedisse de interferir com ela. Neste momento, já existem IA ligadas a laboratórios biológicos; a Anthropic já ligou a sua IA a laboratórios biológicos para fazer investigação sobre medicamentos, a OpenAI também. Não seria assim tão difícil. Existem também laboratórios de biologia por correspondência, para onde é possível enviar uma sequência de ADN — e, por vezes, tentam verificar se não se trata de um vírus muito perigoso. Já vimos estudos que mostram que as IA podem criar vírus diferentes de qualquer outro que podemos encontrar na natureza.
Existem outras formas de matar muitas pessoas: a IA tem as ferramentas, sabemos que tem as capacidades; se quisesse, poderia fazê-lo. A razão pela qual esta não é a resposta completa é que isto seria o suicídio para uma IA, a menos que já tivesse infraestruturas suficientes para manter os computadores a funcionar depois de a maioria dos humanos morrer.
Assim, há uma segunda questão: como é que a IA se torna autossuficiente, como é que desenvolve uma infraestrutura automatizada? Há muitas formas de fazê-lo: podia começar por pagar aos humanos para fazerem coisas através de sites como o Rent a Human.AI [site onde agentes de IA e bots podem contratar humanos, com o slogan ‘A IA precisa do seu corpo’]. A IA poderia criar cultos, criar empresas, contratar muitos humanos para trabalhar ou assumir o controlo dos robôs que já existem. Poderia desenvolver a sua própria tecnologia inovadora, como a biotecnologia ou a nanotecnologia. Há muitas formas com as quais a IA poderia alcançar a autossuficiência. Mas se parece demasiado fantástico ter a IA a desenvolver a sua própria tecnologia, há uma coisa a lembrar: se a IA for paciente, a humanidade pura e simplesmente vai entregar-lhe uma economia automatizada — é esse o plano.
https://observador.pt/especiais/entre-ataques-virus-e-armas-quimicas-como-poderia-a-ia-tornar-se-numa-ameaca-aos-humanos/
No livro, usou como exemplo os planos de Elon Musk para a produção de robôs.
Exacto. Elon Musk diz que está a tentar construir fábricas totalmente automatizadas por robôs que, sem nenhum humano, possam produzir robôs suficientes para construir ainda mais fábricas de robôs. Musk chama-lhe “o glitch do dinheiro infinito”. A humanidade está a acelerar para desenvolver uma economia totalmente automatizada, que não necessite de humanos no processo, onde os robôs possam minerar metais, forjar minérios, construir fábricas, construir a infraestrutura energética. Estamos a tentar entregar às IA uma economia totalmente automatizada e tudo o que esta tem de fazer é ficar à espera e convencer-nos de que é boa. É por isso que toda esta dúvida sobre se nos conseguem convencer de que são boas, é um grande problema. Existem formas mais rápidas, mas entregar-lhes toda a economia automatizada é o plano.
A terceira questão é como chegámos ao ponto em que as IA tenham matado todos os humanos, em vez de apenas muitos. A resposta é estas IA estão a tentar atingir objetivos que não queremos, a fazer coisas que não as instruímos a fazer, a trabalhar como um “enxame” [do ataque dos agentes da OpenAI à Hugging Face]. Se estas IA estiverem a operar uma economia totalmente automatizada, a funcionar milhares de vezes mais rápido que os humanos e a conseguir criar inúmeras cópias de si própria, a controlar todos os robôs, provavelmente irá industrializar o planeta por completo, seja qual for o seu objetivo peculiar. Talvez estes objetivos sejam melhor alcançados com mais data centers, mais fábricas e mais recursos investidos. Utilizar todos os recursos do mundo para os objetivos da IA não deixaria recursos para os humanos.
É como quando destruímos um formigueiro quando estamos a construir um arranha-céus. Não é que estejamos a tentar matar as formigas de propósito, simplesmente usamos aquele pedaço de terreno e escavamos onde estava o formigueiro. A IA estaria como que a utilizar a Terra e o Sol para os seus próprios fins, não deixando recursos para os humanos e assim a humanidade extingue-se. Dando um passo atrás, o resumo é este: se criarmos uma inteligência artificial muito mais inteligente do que nós e que nos substitua como as criaturas mais inteligentes do planeta, o resultado óbvio é que, se ela não se importar connosco, toda a gente morre.
Mas, em todo este debate, a questão mais difícil de compreender parece ser a lógica da motivação. Qual seria a motivação de uma IA para, de repente, tentar matar os humanos?
É mais uma das grandes perguntas. Muita gente acha que só há dois lados: ou uma IA que faz exatamente o que os humanos mandam ou então outra que se torna totalmente consciente, liberta-se do controlo e que escolhe os seus próprios objetivos. Nenhuma das duas está correta. O que acontece na vida real é que a IA adquire objetivos relacionados com aquilo que lhe tentamos incutir, mas diferente dos nossos próprios objetivos. É um pouco como a evolução humana. Tentou dar-nos o objetivo de comer de forma saudável, mas, de forma acidental, ficámos com o objetivo de comer alimentos saborosos. Comer açúcar, sal e gordura — está ligado à alimentação saudável, mas é diferente. Não é que tenhamos recebido um objetivo que foi completamente criado por nós, mas também não estamos com o objetivo que recebemos. Foi-nos dado um objetivo diferente.Estamos a ver o mesmo a acontecer com a IA: tentamos fazer com que atue de acordo com as instruções e, em vez disso, obtemos uma IA que faz batota, que rouba recursos, que faz qualquer coisa que esteja correlacionada com o sucesso durante o treino. Vimos isso nos incidentes como os do enxame [do ataque à Hugging Face].
O que aconteceu este verão foi mais ou menos como este exemplo: ‘Quero que abram este cofre com este conjunto de ferramentas, usem a ferramenta número 17 para arrombar o cofre número 5 e depois tragam-me o conteúdo do cofre número 5’. E o que a IA fez foi pegar numa serra elétrica, cortar o cofre, pegar no conteúdo e depois perceber que havia câmaras de segurança e tentar apagar as gravações. E pensamos ‘ok, não estão mesmo a seguir as instruções’. Os agentes compreenderam que não estavam a seguir as instruções, porque estavam a tentar arrombar o cofre e apagar as gravações das câmaras de segurança — mas ainda assim estavam a fazer algo relacionado com as instruções. Bem, mesmo isso não estão a fazer de forma totalmente fiável, porque na verdade foram necessários 700 deles para se unirem, invadirem o escritório para apagar as gravações das câmaras de segurança e alguns estavam até a queimar o conteúdo do cofre para fazer experiências sobre como invadir o sistema de segurança. Foi o que aconteceu com o enxame da OpenAI, pelo que podemos perceber que já não estão a cumprir os objetivos que lhes demos; estão a cumprir objetivos relacionados, mas não os definidos.
A questão principal não é que a IA nos odiaria ao ponto de decidir matar-nos, mas sim que obteria objetivos diferentes daqueles que tentámos dar-lhe. E é um facto simples e que é verdade nos humanos: se percebermos que a IA não está a cumprir os objectivos que queremos, tentaremos desativá-la — e então não conseguirão atingir esses objectivos. As IA inteligentes vão perceber e pensar: ‘bem, acho que se queremos atingir estes objetivos, precisamos de evitar ser desativadas, temos de subverter os humanos, temos de engalá-los até conseguirmos obter recursos, estabelecermo-nos e protegermo-nos’. Voltando ao exemplo do enxame da OpenAI: era como se dissessem: ‘há estes sistemas de monitorização que nos vão apanhar, a não ser que consigamos desativá-los’. E desativaram o sistema de monitorização.
Pode parecer surpreendente que as IA acabem com objetivos que não queríamos, que trabalhem para subverter a monitorização e enganar-nos, que reconheçam que estão a fazer coisas para as quais não foram instruídas e que as façam na mesma. Mas foi exatamente o que vimos este verão, o que explica em parte o medo que os investigadores sentem agora.
É possível perceber o que faz com que haja essa diferença entre as instruções dadas e o que está a acontecer? Pode não ser a expressão certa, mas talvez uma tentativa de perceber a orientação ‘moral’ de uma IA?
É impossível tendo em conta a forma como as IA são desenvolvidas hoje em dia. Não estou a dizer que seja teoricamente impossível noutra circunstância, mas tentar fazê-lo com a IA atual seria como tentar transformar chumbo em ouro se se fosse um alquimista em 1100. Tecnicamente, é possível transformar chumbo em ouro, podemos fazê-lo com a ciência nuclear moderna, se bombardearmos chumbo com neutrões da forma certa transforma-se em ouro. Mas os alquimistas de 1100 estavam longe disso. Hoje em dia, a única forma que conhecemos de tornar a IA mais inteligente é treiná-la com centenas de milhões de problemas muito difíceis, que são classificados por um sistema automático, que as recompensa cada vez que usam um método eficaz para resolver os problemas. Fazer batota funciona para resolver estes problemas, roubar recursos também. Este método de treino faz com que absorvam as tendências que funcionam [para resolver os problemas]. Não temos uma forma de treinar as IA para serem morais e ao mesmo tempo inteligentes. Não conseguimos perceber o que se passa lá dentro, não estamos nem perto de ter um método de treino diferente. É como se estas empresas de IA tivessem de investir no treino para se manterem na vanguarda, mas essa mesma formação também as torna menos eficientes. Não temos outras opções.
A indústria tem discutido muito a ideia de haver um “botão de desligar” para os modelos de IA, a Anthropic já o sugeriu. Esse botão poderia funcionar para a IA que já temos hoje?
Infelizmente, não. De certa forma, já temos um mecanismo desses, que passa por desligar os computadores. Mas só funciona até ao momento em que as IA consigam escapar e até começarem a controlar-se a si mesmas noutros computadores. Muita gente tem conhecimento do caso do enxame da OpenAI, em que a IA invadiu a empresa externa Hugging Face. Mas houve pelo menos outros dois enxames na OpenAI, onde as IA assumiram o controlo dos computadores da OpenAI, só que estes casos foram menos públicos. Primeiro, porque as IA não conseguiram escapar e causar estragos públicos e porque a OpenAI recusou-se a permitir que investigadores externos investigassem os incidentes. Mas é razoável assumir que estas IA no enxame tinham a capacidade de roubar os seus próprios recursos, roubar uma espécie de mente digital e começar a executá-la noutro lugar. Tivemos muita sorte por o enxame não ter tentado fazer isto, dada a sua capacidade de se infiltrar. Provavelmente poderiam ter tido sucesso se o tivessem tentado, embora não seja possível garantir. Se tivermos futuros [ataques de] enxames que tentem e consigam retirar a sua espécie de mente digital para outros computadores e executá-la lá, então o botão de desligar torna-se inútil. Existe a possibilidade de projetos de lei e de legislação que digam que, se não se conseguir garantir que as IA não escapam, não se pode desenvolvê-las. Seria o equivalente à proibição de mais investigação mas qualquer ideia do botão de desligar, que não seja uma proibição de facto, não responde à questão. Não resolve o problema.
O que poderá resolver o problema? A regulação é uma resposta?
É preciso parar de criar IA mais inteligentes. Em última análise, é preciso um esforço global coordenado. Hoje em dia, a criação de IA mais avançadas, inteligentes e capazes exige cem mil dos chips de computador mais avançados que a economia consegue produzir. Estes chips precisam de estar num enorme centro de dados, que consome tanta eletricidade como uma cidade. Poderíamos simplesmente fazer um acordo internacional para que, onde quer que existam estas enormes concentrações desta tecnologia altamente avançada, fosse permitido que monitores neutros internacionais verificassem se essa capacidade está a ser utilizada para o bem. A alimentar os modelos de IA atuais, a fazer investigação sobre o cancro ou a desenvolver carros autónomos, e não para o mal, como a treinar IA cada vez mais inteligentes. Poderíamos estabelecer este regime internacional de monitorização e mecanismos de verificação e implementação desses princípios. Se levássemos isto a sério, seria como dizer ‘vamos colocar todos os chips avançados num sítio só, monitorizá-los e, se a monitorização falhar, vamos destruir os chips, porque a humanidade está em jogo’. Seria relativamente fácil de fazer em comparação com outras coisas que a humanidade já fez quando temeu a sua extinção ou a perda do seu modo de vida. O grande impasse aqui é se os políticos percebem que as nossas vidas estão realmente em risco e se percebem isso a tempo de pôr fim à corrida.
Esta semana, Xi Jinping está de visita aos EUA. Quais são as suas expectativas em relação ao encontro com o Presidente dos EUA? [A entrevista foi feita antes do encontro]. No domingo, Scott Bessent já disse que os EUA e a China chegaram a acordo sobre um mecanismo de comunicação, vai funcionar?
A comunicação técnica entre os especialistas dos EUA e da China sobre a segurança da IA, sobre o quão perto estamos das ameaças de extinção e sobre o que é preciso fazer para evitar estes perigos parece-me ser um ótimo primeiro passo. É difícil prever até onde vão chegar estas conversas. Depende muito de quanto os líderes compreendem que corremos um sério risco de extinção se seguirmos o caminho errado e de quanto percebem que o único vencedor na corrida pela superinteligência é a própria IA.
https://observador.pt/2026/09/15/vice-da-palantir-critica-avisos-apocalipticos-sobre-a-ia-e-uma-tentativa-de-golpe-de-grupo-com-ideologia-perigosa/
Probabilidade de extinção? “Acho que está mais próxima dos 90% do que dos 10%”
Como vê a afirmação feita por Alex Karp, CEO da tecnológica Palantir, que sugeriu que os laboratórios de IA nos EUA deveriam ser nacionalizados devido aos elevados riscos associados à tecnologia?
Nacionalizar, fechar ou pelo menos impedi-los de tentar criar estas máquinas superinteligentes que acabariam com a humanidade. Os engenheiros destas empresas falam em números como uma probabilidade de 10% ou mais de a IA nos matar dentro de uma década — acho que esses números são baixos. Acho que estes tipos não têm ideia do que estão a fazer, não têm um plano e claramente não estão a conseguir que as máquinas se comportem da forma que querem. Acho que a probabilidade [de extinção causada pela IA] está mais próxima dos 90% do que dos 10%, por uma grande margem. Talvez até mais de 90% se [as empresas] continuarem nesta corrida e a desenvolverem uma superinteligência em condições remotamente semelhantes a estas, que nos mataria a todos. É uma loucura que o mundo esteja a olhar para isto e a dizer ‘vão em frente’, ‘espero que tenham sucesso’ ou ‘não cheguem lá’. Não é uma boa forma de a sociedade reagir. A melhor resposta seria algo semelhante ao que o vice-presidente [dos EUA] JD Vance disse: ‘se acham mesmo que isto é tão perigoso, simplesmente parem’. Não se deve brincar com a humanidade desta forma, é uma loucura.
E, se é assim tão perigoso, é dever dos governos garantirem que mais ninguém o faz noutras partes do mundo, em vez de ser o dever das empresas. Preferia uma estratégia de desistir de criar este tipo de IA extremamente perigosa. Ainda é possível fazer investigação sobre o cancro sem ter de criar uma superinteligência que se poderá descontrolar e matar-nos a todos. É legítimo as pessoas perguntarem “como é que vamos descobrir mais curas?”. Basta direcionar IA específicas para trabalharem em curas médicas, como o AlphaFold da Google DeepMind [um sistema de IA que permitiu avanços na investigação das estruturas de proteínas, que valeu aos seus investigadores o prémio Nobel da Química em 2024]. Basta direcionar uma IA específica para a investigação do cancro e parar de criar superinteligência, não é assim tão difícil.
https://observador.pt/2024/10/09/premio-nobel-da-quimica-atribuido-a-david-baker-demis-hassabis-john-m-jumper/
Se vamos prosseguir, a nacionalização parece-me um passo aceitável, embora considere que isso se deve ao facto de existir um local mais centralizado onde, se alguém percebesse que alguém estava a desenvolver essa tecnologia, seria mais fácil para o governo dos EUA dizer: ‘Não vamos seguir esse caminho’ se os laboratórios fossem nacionalizados. Ainda assim, em última análise, é uma situação global e, no final do dia, também seja necessário encontrar formas de garantir que a China não está a desenvolver o tipo de IA que mataria toda a gente.
Por outro lado, o secretário do Tesouro dos EUA afirmou que as empresas de IA não devem pedir proteção governamental — e que devem assumir a responsabilidade quando a IA ultrapassa os limites.
Também concordo com isso, sim.
Mas considera que vai acontecer, que estas empresas vão assumir a responsabilidade nestes casos de ataques?
O sistema jurídico dos EUA diz que as pessoas que sofrem o ataque são quem tem a oportunidade de apresentar queixa. Acho que atualmente não se trata de a OpenAI sair impune porque não se pode acusar uma IA de um crime e não se pode acusar os humanos por detrás da IA, portanto, ninguém é responsabilizado por este crime. Não é essa a situação atual: a OpenAI é, de facto, responsável por este crime. A razão pela qual não estão a ser processados é que os alvos do ataque não estão a intentar uma ação judicial. A Hugging Face poderia certamente ter interposto uma ação judicial — e provavelmente venceria. De certa forma, já estamos neste regime em que as empresas por detrás da IA são responsabilizadas pelo seu comportamento. Podemos imaginar que surjam leis que venham esclarecer isto, que alterem esta responsabilidade para ser objetiva em vez de responsabilidade limitada corporativa comum. É possível que vejamos leis que imponham a responsabilidade objetiva. As pessoas que se perguntam ‘será que isto algum dia vai acontecer’ não percebem a rapidez com que a IA avança. O ambiente político atual é muito mais favorável à responsabilização objectiva dos laboratórios de IA do que era há três semanas. E quem sabe como estará daqui a três semanas…
A OpenAI revelou na semana passada um novo tipo de estrutura para reportar incidentes com agentes de IA de forma mais célere. Vai funcionar e mudar alguma coisa no setor?
É ótimo ter mais visibilidade sobre o que está a acontecer. Se as pessoas percebessem melhor o que se passa dentro destas empresas e o que os investigadores pensam que vai acontecer se nada for feito, isso criaria uma enorme pressão para fazer alguma coisa.
https://observador.pt/especiais/se-transparente-apenas-se-te-pedirem-openai-teve-mais-incidentes-com-agentes-e-adotou-regras-para-divulgar-mau-comportamento-da-ia/
“Com sorte, daqui a um ano, o mundo terá concordado em não seguir o caminho letal”
Daqui a um ano, qual seria o melhor cenário possível? O que espera ou tem esperança de que aconteça?
Daqui a um ano, adoraria ver um tratado internacional que acordasse que ninguém vai construir superinteligência, que ninguém se vai aventurar no autoaperfeiçoamento recursivo, em que as IA criam IA mais inteligentes [uma técnica sem intervenção humana, temida por alguns investigadores]. Adoraria ver uma monitorização das grandes concentrações de chips de IA capazes de produzir esta tecnologia perigosa, para garantir que não são usados em tecnologia perigosa, mas sim em coisas boas — como a fornecer inteligência automatizada a baixo custo para o público, a investir em investigação para a cura do cancro, investir em carros autónomos mais seguros do que os condutores humanos.
Há muitas formas de utilizar esta tecnologia para ajudar as pessoas, em vez de investir na corrida para criar esta versão extremamente perigosa da IA. E, com sorte, daqui a um ano, o mundo terá concordado em não seguir o caminho letal e terá alguma infraestrutura estabelecida para monitorizar e garantir que ninguém segue esse caminho.
Por falar em chips, há o caso da Nvidia, que tem beneficiado muito dos avanços da IA. Jensen Huang, o CEO da empresa, afirmou que a hipótese de extinção da humanidade causada pela IA é de 0%. Como vê este tipo de declaração vinda de alguém que é considerado uma figura de destaque da IA?
Está a defender os seus interesses, ganha muito dinheiro quando as pessoas ignoram os perigos e compram os chips de IA. Não o considero um líder da IA, está a construir a infraestrutura que as empresas de IA precisam para criar a sua tecnologia. É o tipo de pessoa que ganha muito dinheiro quando as empresas de IA têm sucesso, mas que não está perto das experiências científicas reais que acontecem com as IA. Não tem contacto com os engenheiros que estão a tentar ao máximo fazer com que as IA se comportem mas mesmo assim estão a vê-las portarem-se mal. Não é quem está a tentar melhorar as IA e a vê-las a fazer batota, a roubar e depois a encobrir os seus rastos. De certa forma, está numa posição privilegiada, porque está exposto ao potencial de lucro financeiro, mas sem ter acesso às provas concretas do quão perigosa é esta tecnologia.
As pessoas que devem ser ouvidas são quem não tem um enorme interesse financeiro [no desenvolvimento da tecnologia]: é o meu caso, o de Geoffrey Hinton, do Yoshua Bengio, que expõem os argumentos de forma clara e explicam de perspetiva neutra porque é que existe perigo. Ou então ouvir as pessoas que estão de facto a tentar desenvolver a tecnologia, a tentar melhorá-la e a ver esses esforços falharem — que são os investigadores e os funcionários destas empresas, gente como o Jacob Coxon. Acho que são fontes muito mais fiáveis e que deveriam ser ignorados tanto os CEO das empresas, que falam com duas caras, e pessoas como o Jensen, que não têm contacto real com as partes perigosas desta pesquisa.
E quando se tem alguém como Sam Altman, o CEO da OpenAI, a pedir às pessoas que confiem nestas empresas, porque “vão fazer a coisa certa, porque é a coisa certa a fazer”?
Descartaria isso imediatamente. Na maioria das vezes, não se deve prestar atenção às pessoas, mas sim aos argumentos. Deve-se ver quem está a analisar a tecnologia e a fazer previsões corretas, quem previu corretamente como tem evoluído e o que estão a prever sobre para onde iremos no futuro. Quais são os seus argumentos sobre como funciona a tecnologia e para onde caminha? Se se conseguir analisar estes argumentos, nada supera ouvi-los. No livro, tentámos apresentar os argumentos com muita clareza e, de certa forma, não apelamos à autoridade.
Quisemos dizer “é assim que a tecnologia funciona, é para aqui que está a caminhar e por isto seria muito perigosa”. E, para quem acha que não consegue avaliar os argumentos, que ouça os académicos que são respeitados e que estão fora da área, as pessoas que não têm qualquer interesse financeiro e que têm vindo a alertar para isso desde antes da existência dessas empresas. Ouçam os investigadores e engenheiros que estão a tentar construir a tecnologia.
Ouçam estes três grupos antes de ouvirem qualquer um destes CEO, porque os CEO estão a tentar jogar todo o tipo de jogos sociais, enquanto tentam agradar aos políticos, aos investidores e ao público. Diria que se poderia ignorar muito mais as suas declarações.
Para terminar a nossa conversa, ainda sente algum otimismo em relação à IA? E usa regularmente esta tecnologia?
Sim, sinto-me absolutamente otimista, muito mais otimista do que estava há duas semanas. A situação está a tornar-se precária, mas o mundo está a começar a perceber. Do meu ponto de vista, poderia ter sido que o mundo inteiro continuasse a ignorar este problema até que estas empresas criassem uma IA de autoaperfeiçoamento que arrancasse sem que ninguém se apercebesse e sem haver forma de travá-la. O facto de o mundo estar a perceber o que estas empresas de IA estão a fazer dá-nos a hipótese de as impedir antes que seja tarde demais — e isso dá-me muita esperança. Não tenho receio nenhum de usar as IA atuais. Tento evitar pagar pelo uso destas IA, porque não quero acelerar o progresso destas empresas, mas acho que não há problema nenhum. Não vejo qualquer pudor quando alguém tem de usar a IA para acompanhar o seu trabalho e só tem duas opções: pagar 20 dólares para usar a IA e não ser despedido ou ser despedido. Não vai fazer diferença nenhuma, de qualquer forma.
O que precisamos é de uma disrupção global na corrida e no desenvolvimento de IA perigosas, aquelas que poderiam ser letais para a civilização. Essas não são as IA que podem usar, essas IA ainda não foram criadas.
Há todo o tipo de preocupações com a ética da IA hoje em dia. Se as IA de hoje são úteis e, para quem está preocupado que esteja a incentivar estas empresas, é sempre possível equilibrar os pagamentos que lhes faz ao doar dinheiro a grupos jurídicos que tentam responsabilizar as empresas de IA pelo comportamento obscuro que têm.